杂项提示词
开发本站用的提示词,仅供参考。
001 starred
请深度思考。
- 请阅读 .github\workflows\schedules.yml 工作流文件。
- starred 是一个 Python 包, schedules.yml 工作流就是使用了该包实现 github stars 信息读取的。请帮我查询该包的命令行参数信息,我希望搞懂全部能用的命令行参数配置。
002 设计一个按照 markdown 二级标题拆分文档数据的 typescript 脚本
- 完整的,全面的阅读以下文档。了解清楚要被拆分拆解的文档文本结构。
https://ruan-cat.github.io/stars-list/topics.mddocs/topics/index.md
- 文档结构包含了很多二级标题。
- 在
docs内制作一个 typescript 脚本,实现文档数据拆分。 - 在
docs\.vitepress\config.ts内,在setUserConfig函数调用前执行该脚本提供的处理函数。
脚本读取二级标记数据并新建文件的实现流程
- 直接阅读
docs/topics/index.md文件。 - 读取全部的二级标题,根据二级标题作为全部的
topics主题。 - 读取的二级标题内,排除掉
Contents和License这两个标题,这两个标题不是有意义的topics主题。 - 根据你获取到的主题,在
docs/topics/index.md内读取每个段落的正文。 - 根据 topics 主题,在
docs\topics目录内新建以 topics 主题命名的 markdown 文档。- 新建文档,其正文就是读取的每个
docs/topics/index.md段落的正文。 - 每一个
docs/topics/[topics].md文档的一级标题,就是对应的 topics 名称。 - 每一个
docs/topics/[topics].md文档的结构只有两个:- 以 topics 命名的一级标题。
- 正文
- 新建文档,其正文就是读取的每个
代码编写要求
- 脚本编写到
docs目录内。 - 为 typescript 脚本。
- 控制台输出用 consola 来输出信息。
- 必须使用
consola.withTag的方式创建logger,并直接使用logger来输出打印日志。即:
// 获取依赖包的包名 版本号
import { name as packageName, version as packageVersion } from "../package.json";
// 用包名作为日志的标签前缀
const logger = consola.withTag(packageName);
// 然后无条件的开始输出包的信息
logger.info(`${packageName} v${packageVersion} is running...`);003 制作一个标题数据格式调整脚本
- 制作一个 typescript 脚本。
- 阅读
docs\topics\index.md文档。实现标题文本的重新编写。 - 仅仅只阅读这一小块文本,即一级标题:
# Awesome Stars [](https://github.com/sindresorhus/awesome)- 将一级标题的文本格式改写,改写成如下格式:
# Awesome Stars
[](https://github.com/sindresorhus/awesome)你只需要将 barge 徽章从一级标题内换到下面一行即可。并在中间保留一行空行。
代码编写要求 spec
- 在 docs 内编写脚本。
- typescript 脚本。不是 javascript。
- 代码格式和风格,模仿
docs\split-topics.ts。 - 其他的代码编写风格 spec 规格,请阅读
openspec\changes\archive\2025-12-11-add-topic-splitting-script\specs\development-guidelines\spec.md文档。
脚本使用规范要求 spec
- 在
docs\.vitepress\config.ts的splitTopics函数之前,在copyReadmeMd之后调用。
004 设计一个检查指定 github user 用户仓库全部 TODO 待办任务的工作流
这是一个产品调研、技术方案调研,和落地任务设计的任务:
我需要你做一个对 https://github.com/ruan-cat 用户,也就是我的仓库信息专项收集的执行函数方案。
我要你以 node 的方式,通过接口请求的方式,实现对指定用户全部开源或闭源项目的信息收集。按照特定的文本查询正则,来获取信息,并制作格式化数据。
需要收集的信息
- 按照特定文本规则,根据 TODO 这个关键词获取的文本。
- 该文本所在:
- repo 仓库名称
- path 完整的相对根目录的文件路径
- git 分支名称
- line number 所在的文件行数
要收集的信息以及正则规则管理
你需要收集形如这样的文本信息:
- 在 markdown 内的二级标题
你提取的文本是: 持续推进二期 AI 项目改造
## 006 <!-- TODO: 2026-8-24 codex 正在做 --> 持续推进二期 AI 项目改造你提取的文本是: 换接口请求模型为 claude-sonnet-5[1m] ,并做出其他相应的改动
### <!-- TODO: ZCode正在做 --> 换接口请求模型为 `claude-sonnet-5[1m]` ,并做出其他相应的改动提取文本为: 调研合适的 nitro 接口生成接口请求信息表的工具
## 005 <!-- TODO: --> 调研合适的 nitro 接口生成接口请求信息表的工具提取的文本为: 尝试更换付款方式的虚拟卡为美国卡
## <!-- TODO: --> 尝试更换付款方式的虚拟卡为美国卡- 在 markdown 内裸露的单行且无内容的 TODO。
<!-- TODO: -->在这种情况下,你提取下面最近的一行,通常是这样的:
<!-- TODO: -->

回到本项目,针对 `docs\plan\2026-8-25-up-to-latest-nitro` 文件。

更新上述报告的主体。上述报告的主体是以 `D:\code\ruan-cat\learn-nitro-starter-with-vercel` 的身份写的,不是以 `D:\store\WorkBuddy\2026-6-30-common` 的身份写的。这个时候你提取的是这一行: 回到本项目,针对 docs\plan\2026-8-25-up-to-latest-nitro 文件。
- 在 markdown 内裸露的单行且有内容的 TODO。
<!-- TODO: 后面再考虑提供更好看的动效 现在暂时没有需求 -->你提取这一行: 后面再考虑提供更好看的动效 现在暂时没有需求
- 在 markdown 内嵌入某行的 TODO。
1. <!-- TODO: 可接受的优化 --> **先降低默认输出成本。** 默认 stdout 只返回摘要;增加显式完整审计开关。摘要至少包含 `Mode`、`CandidateCount`、候选 PID、阻断原因聚合、WorkBuddy 分组、停止结果、验证结果和是否存在 respawn。你提取的是这一行: 可接受的优化
- 在其他格式文件的 TODO。
// TODO: 实现图标变化的动效你提取的是: 实现图标变化的动效
/**
 * http的接口传参方式
 * @description
 * 用于控制接口请求时的参数传递方式
 * @see https://www.cnblogs.com/jinyuanya/p/13934722.html
 *
 * @description
 * 警告 该配置目前失去意义
 *
 * 该配置目前不再被使用了 不会被任何函数使用 配置起来属于无意义内容
 *
 * 未来会被删除 并重新整理对应的接口生成成果
 *
 * TODO: 准备删除该工具
 */
export type HttpParamWay =
	// 路径传参
	| "path"
	// query传参
	| "query"
	// body传参
| "body";你提取的是: 准备删除该工具
格式匹配黑名单
## 015 <!-- TODO: -->你什么都不提取。不要做任何识别和处理。
制作用 tsx 直接驱动的 typescript 脚本
你需要制作一揽子用 tsx + typescript + node 执行的脚本,来实现需求。在 scripts\get-todo 目录内编写你的脚本。
这些脚本的有效交付物应该是一个巨大的 json 文件。至于这个 json 文件存储在哪里,由你来给出设计。
未来可能的使用场景
- 直接在 window 环境内,我点击根包内已经封装好的命令来完成信息收集。生成出 json 文件。
- 在 github workflow 内,通过每天执行一次 tsx 执行的脚本,获取到脚本信息。
- 未来可能直接在 vitepress 内,通过纯异步请求的方式完成信息获取,并根据交付物直接刷新 vitepress 站点内的 vue 组件,实现页面更新。实现用户点击按钮,就即时获取到最新数据的效果。
验收与校验方式
你自己设计。按理说在 window 内执行一次脚本就行了。你设计。
2026-8-26 沟通
你说的对,我们的 token 这样获取:
如果你发现在本地 window 执行的时候,没有可以用的环境变量获取到个人级别的环境变量,那么你就默认只查询开源仓库,不查询私人仓库。
如果你在 github workflow 内运行时,那么你必须要查询私有和公开仓库,因为给 github workflow 肯定会给你提供 user token。
运行时优先读取 GITHUB_TOKEN,兼容我现有的 GITHUB_PAT_TOKEN
你说的对,branch 分支的查询细节我没有考虑清楚。
分支扫描策略如下:
- 优先扫描名为 dev 的开发分支。因为我的主分支经常不更新。
- 目标 repo 仓库没有 dev 分支时,默认查询 main master 分支。即主分支。
你考虑的很好。我们现在只按照这样的方式来做查询。我们只查询 TODO ,只查询大写的 TODO。就这 4 个大写字母。
允许 TODO 后有冒号和空白。todo: 修复 是不识别的。这是小写。
TODOLIST 不识别。这不是单独的文本。
TODO: 是识别的。特别是大写字母且带有冒号的。
采用“向下跳过空白行,取第一条非空文本行;遇到下一个标题、代码围栏或另一个 TODO 就停止并记录 unresolved_empty_todo,避免误把结构行当待办”的规则
我确认
顺便更新 .github\workflows\schedules.yml 的 git commit message 写法,按照我常见的 git-commit 技能的指导,来完成 git commit message 的字符串模板编写。就像你在 .github\workflows\get-todo.yml 写的一样。
2026-8-26 思考配额受限的问题
我们受限于 github api 的配额问题,这是我们之前调研没想到的。我们还有哪些方案,可以跳过这个 github api 配额问题的?用本地浅克隆形式的 git clone 或者是 degit 方案,可以实现基于本地文件的快速查询么?
这个方案在本地 window 和云端 github workflow 都合适吗?
005 实现基于 vitepress vue 页面的功能
你做的很好,请你完成上下文压缩,我准备开始新的任务了。
新任务:我要实现 vitepress 内提供一个特定按钮,点击按钮就能主动实现请求,获取待办信息,并且适当的更新文件。
在 vitepress 页面内,我点击按钮,就能经可能的获取数据。然后完成最新的信息更新。
接口请求我要求用 vue-qurey 这个包完成适当的请求去重、中断、和缓存的要求。
在 vitepress 获取的信息,是最新获取的信息。你把网站现存的 artifacts\github-todos 工件信息,和最新由用户手动获取的信息,做好 merge 对象合并,确保能显示数据。因为我要考虑接口请求失败后的页面降级显示效果。
本地和生产环境的浏览器测试,用 agent browser 来实现。
- 只做“重新读取现有 artifact”(无需后端,但不是真正刷新)。我们只是做 vitepress 层面上的主动获取最新内容,确实不能直接修改 github 仓库内的文件工件。我这边可以接受这样的边界,在 vitepress 内点击刷新时,获取的数据是一次性的,并且存储在浏览器里面。并不能,也不要去更新 github 仓库内的实体 todo 信息表 json 文件;
- 实现本仓库的 VitePress 页面、vue-query 查询/突变层和 endpoint 契约。我们不做额外的服务端,没必要复杂化,不认为这个项目还要涉及到服务端业务。很麻烦。
- 适当更新文件,我说错了,我仔细思考了一下,我们不实际去更新文件。我刚才说的不对。不合适。如果在 vitepress 层面上更新文件,那么要做 github push 的,这个对于 vitepress 功能来说不合适。
- vue-query 依赖与缓存。当然要增加插件。我要持久化的行为,持久化到 localStorage。这个要的。你设计合适的持久化时间吧。毕竟我要考虑 github api 限流限额的情况,所以实际上这个行为并不是高频执行的接口,允许你设计稍微长一点的缓存时间;
- 生产验证目标。按照你说的来做吧;
统一抽象为 VITE_GITHUB_TODO_ARTIFACT_URL 环境变量
合并优先级,按你说的;
按照你说的,新建独立的 todo 页面。这里的涉及到前端设计,你用合适的工具完成前端设计。
数据缓存 30min。
Vue Query API 边界分工,由你来设计,我同意;
提供公开 raw GitHub URL 作为默认值。允许覆盖。按你说的设计;
我说的是 vue-qurey 的接口数据,缓存 30min 作为有效期。
沿用现有 Teek 主题的色彩/暗色模式。做一个合适的,能够筛选仓库,路径,分支,树形图的复杂 vue 组件。我希望你去参考 FanaticPythoner.better-todo-tree 这款 vscode 插件的界面设计。我做那么多,其实就是希望实现一个云端形式的 FanaticPythoner.better-todo-tree ,便于我控制。了解进度。至于实现的组件库,我这边想做出尝试和改变,我们大胆的使用 nuxt 和 shadcn/ui 的组件库来实现页面效果。而不是我常用的 element-plus ,我想尝试新的组件库挑战;
接收轻量级 schema 检查。
采用 nuxt 生态提供的通用形式组件库,采用 shadcn-vue 组件库;
使用你的 superpower 能力,打开浏览器,给我绘制合适的视觉 UI 设计与交互方案,让我提前做出判断和选择。
另外,我要求你在本项目内存储你设计的 html 设计稿原型,也 git 提交。
本地生成/维护 shadcn-vue 风格组件,底层使用 Reka UI,不引入运行时远端依赖”执行。
我有问题,现在 GitHub Pages 部署 和 GitHub TODO 扫描 Workflow,都会产生文件。一个是 pnpm build 的时候,执行的文件拆分,所以生产环境一直都是产生新的 markdown 的,一直会修改 markdown 的。只不过我过了那么久,本地从来没有 build 过,所以才出现一大堆的 markdown 修改。是不是这样理解?
GitHub TODO 扫描 Workflow,产生了 artifacts\github-todos 的工件,这些工件会被另外一个工作流 build 的时候,被识别么?两个工作流都在修改文件,最后实际 build 的时候能获取到另外一部分的信息么?
这两个工作流的工件,是不是事实上错位啊?比如 build page 的工作流,可能拿到的是稍微旧一点的 TODO 工件啊?
持续完成 vitepress vue 的测试和生产环境 github workflow 测试
你能确定我们的云端 github workflow 任务,能够完成全量的信息获取么?你有做测试么?你能做主动的触发并联调测试么?
我现在授权你 git commit。
你对全部内容做分门别类编写提交信息,然后 git commit,然后 git push,rebase 到 main 分支。并且用 github MCP 或者 gh cli 完成 github workflow 的主动触发,校验检查 github workflow 的任务工件生成效果。是否能完成开源和闭源仓库的 TODO 信息获取。
用这种通用的方式不行吗?难道 github workflow 不能实现获取通用的 github token 么?
由你来执行命令:
gh secret set GITHUB_PAT_TOKEN --repo ruan-cat/stars-list
我提供给你通用的 GITHUB_PAT_TOKEN ,即
执行一次 package.json 的 format 命令,全量格式化一次。
然后执行 git-commit,对度全部内容做一次 git commit,然后 git push,然后你 rebase 合并到 main 分支内。确保 main 得到最新代码。
2026-8-27 持续完成生产环境验证
我已经修复了 vitepress 站点的部署故障,现在 vitepress 站点已经有了最新的修改了,请你继续完成生产环境 https://ruan-cat.github.io/stars-list 的验证。
006 处理工作流不继续执行的问题
- PR 目标和信息表:
- 你的 pr github 仓库地址为: https://github.com/ruan-cat/stars-list
- 你的 pr 目标分支为: dev
- 你的 pr 工作主分支为: 2026-8-27-fix-deploy-github-page
我的 https://github.com/ruan-cat/stars-list/actions/workflows/deploy-github-page.yml 工作流有很奇怪的问题,已经完成 build 了,但是不能继续部署了,卡在那个环节 6 小时了,然后工作流被迫自动取消。这是为什么啊?
问题已经从最开始的“GitHub Pages 怎么卡住了”,收敛成了非常具体的:
VitePress 已正常完成 client bundle、SSR bundle 和页面渲染,但 SSR 过程中产生的 Node 定时资源使 CLI 无法自然退出。已发现 Popover → usePopoverSize() → useWindowSize() 会错误地在 SSR 中创建 timer;下一步需要区分这些短 timer 与最终长期保活的 timer。
真正让进程长期不退出的不是 Teek 的 100ms timer,而是 TanStack Query 创建的一个 7 天 GC 定时器。
真正让进程长期不退出的不是 Teek 的 100ms timer,而是 TanStack Query 创建的一个 7 天 GC 定时器。
你按照本仓库 .agents\skills\fix-bug\record-bug-fix-memory\SKILL.md 技能的要求,在 .agents\skills\fix-bug\record-bug-fix-memory 写经验教训。
你在 docs\reports 内为本次事故编写一个完整的事故链路,问题追踪,排查手段,以及故障解决的说明报告。
重点说明为什么 TanStack Query 创建的一个 7 天 GC 定时器 会导致如此严重的故障,以及该情况是否很容易的导致其他项目也出现类似的问题?
007 重构 README.md 的定位
- 重构
.github\workflows\schedules.yml,schedules.yml 不再继续输出信息到根目录的 README.md 了,只保留剩下的一个函数来完成内容获取。 - 根据我们项目的具体情况,重新编写有意义的 readme 文件。现在的 readme 事实上是不可阅读的。
008 add favicon
我们项目需要一个 favicon icon,要不然看的不好看,请你想办法设计一个出来。这个考验你的设计能力了。
009 继续优化 TodoDashboard 的视觉效果
- 用 memorix 先获取上一轮关于 vitepress todo vue 组件的实现效果。接下来我们完成功能的优化。
- 截止目前,我们核心的 github workflow
.github\workflows\get-todo.yml确实是正常运行,且提供了有效的 git commit。自动化效果实现了。 - 基于本地 window 的自动化获取 todo 的效果也实现了。
- 但是我们的在 vitepress web 页面,手动点击获取的接口请求逻辑,却没有实现好。这个接口请求的功能完全不能用。
- 截止目前,我们核心的 github workflow
- 针对 vitepress web 页面重新获取 todo 信息的功能,你要完成有意义的接口请求,处理这个 bug。
- 针对
docs\.vitepress\theme\components\TodoDashboard.vue的整体视觉效果,和前端层面的交互优化- 增加一个按钮,实现树形图的平铺切换效果。点击切换树形图、和平铺图的视觉效果。
- 仓库的下拉单选框,你要做最基础的滚动条,和弹框高度限制。你这个不限制基础高度的,万一以后的仓库越来越多怎么办?你考虑好这个问题了么?做的太偷懒,太蠢了。
- 看下面的内容时,我无法看右侧信息面板。内容完全错位。这个做的很差。我觉得我们这个 TodoDashboard.vue ,整个界面应该要恰当的提供一个高度。做好基于左侧 TODO 信息的滚动条。而 TodoDashboard.vue 要恰当的占满当前 vite 页面的剩余可用的高度。不要出现双滚动条。左侧 TODO 信息很多的,我们的数据很多,700 多条 todo 数据,所以要设计合适的滚动条,和面板页面高度的计算控制。
你做的很好,不过还有一些小问题没做好:
- 如果浏览器的分辨率发生改变。那么会出现按钮遮挡。比如这里的 github 打开按钮,就被遮挡了。
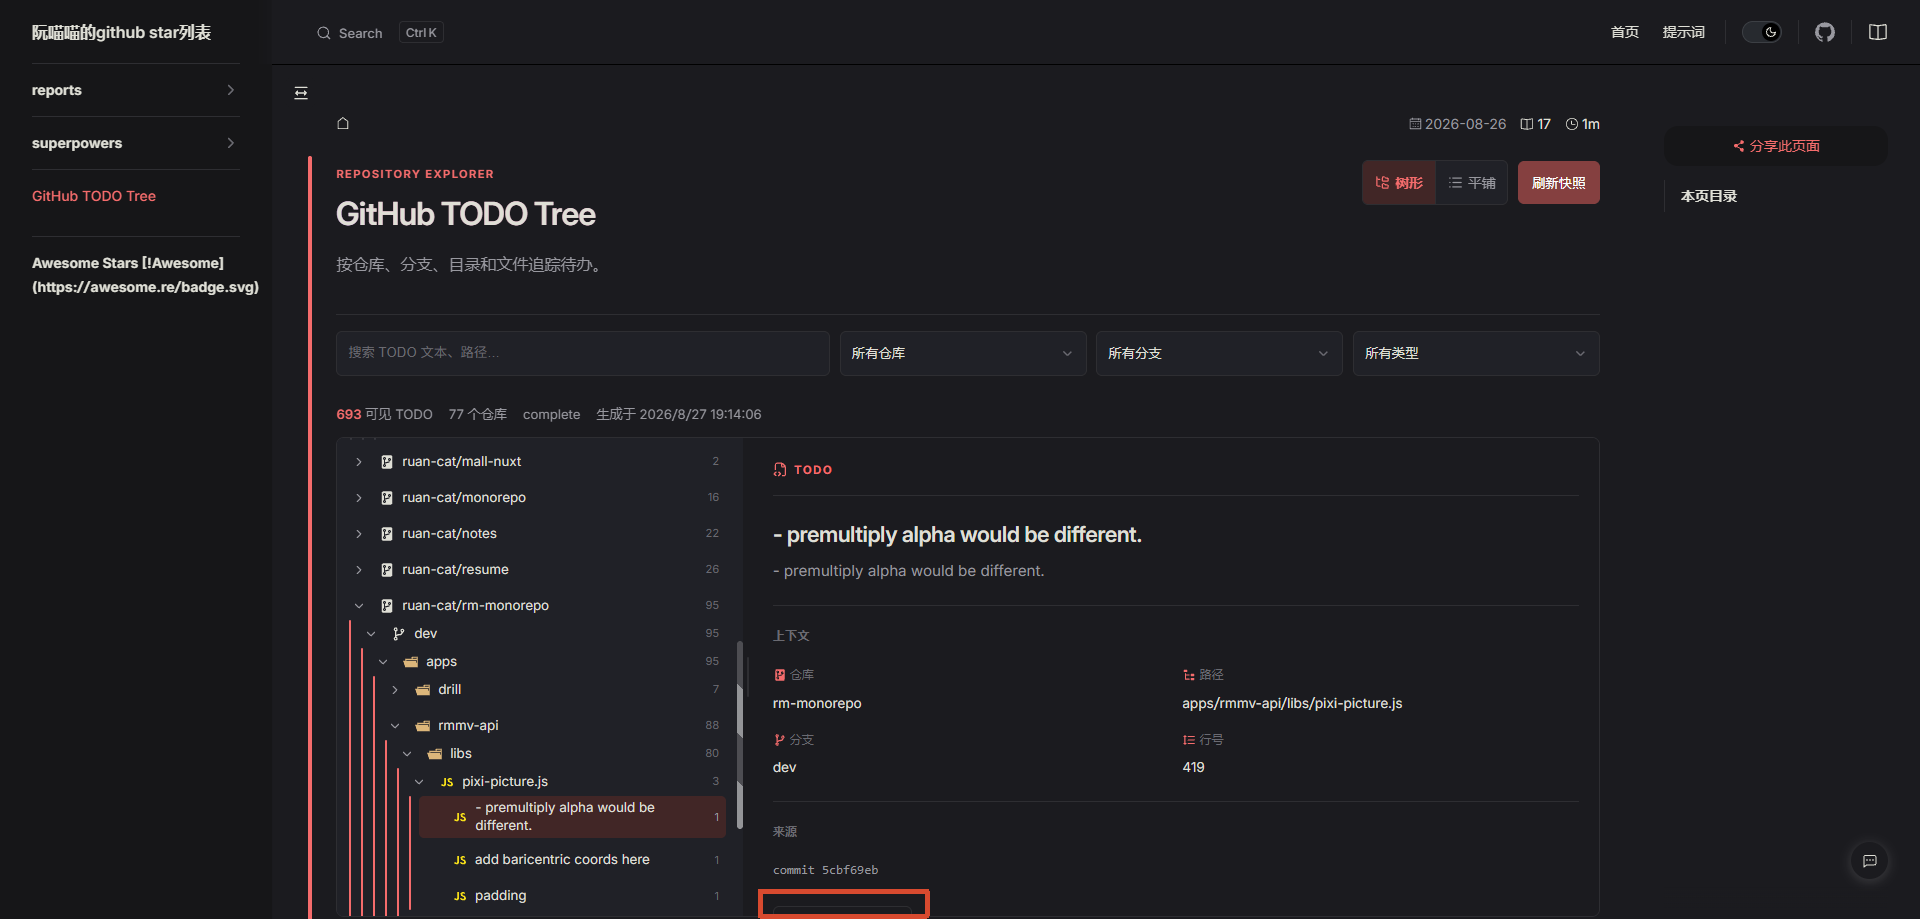
- 仓库下拉单选框,我要求你增加必要的滚动条。这里是需要必要的滚动条,来给用户手动滚动的。
- 下拉单选框这里,我要求你在前面增加合适的 iconify,做好区分和筛选。开源仓库你设计一个 iconify,闭源仓库你也设计一个 iconify,这样我就能根据 iconify 图标做出筛选。以后仓库多了,我怎么知道那些是开源的,那些是闭源的么?对于闭源仓库,我要求的是你用一个
锁样式的 icon 来完成。开源的仓库的 iconify,你自己做出合适的设计。
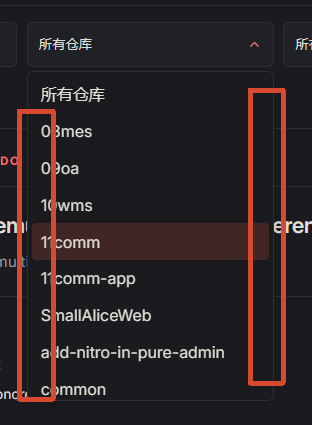
你先完成一次 git-commit,对目前全部的 git 工作区的内容,做一次分门别类编写提交信息。然后你再继续解决我给你反馈的问题。
- 项目有明显 bug,你上次修改的 github 仓库下拉列表,现在坏了。我选中东西后,弹框没办法自动关掉了。鼠标失焦后不是自动关闭你这个下拉框么?你怎么为了实现样式效果,把核心交互功能给我搞丢了?
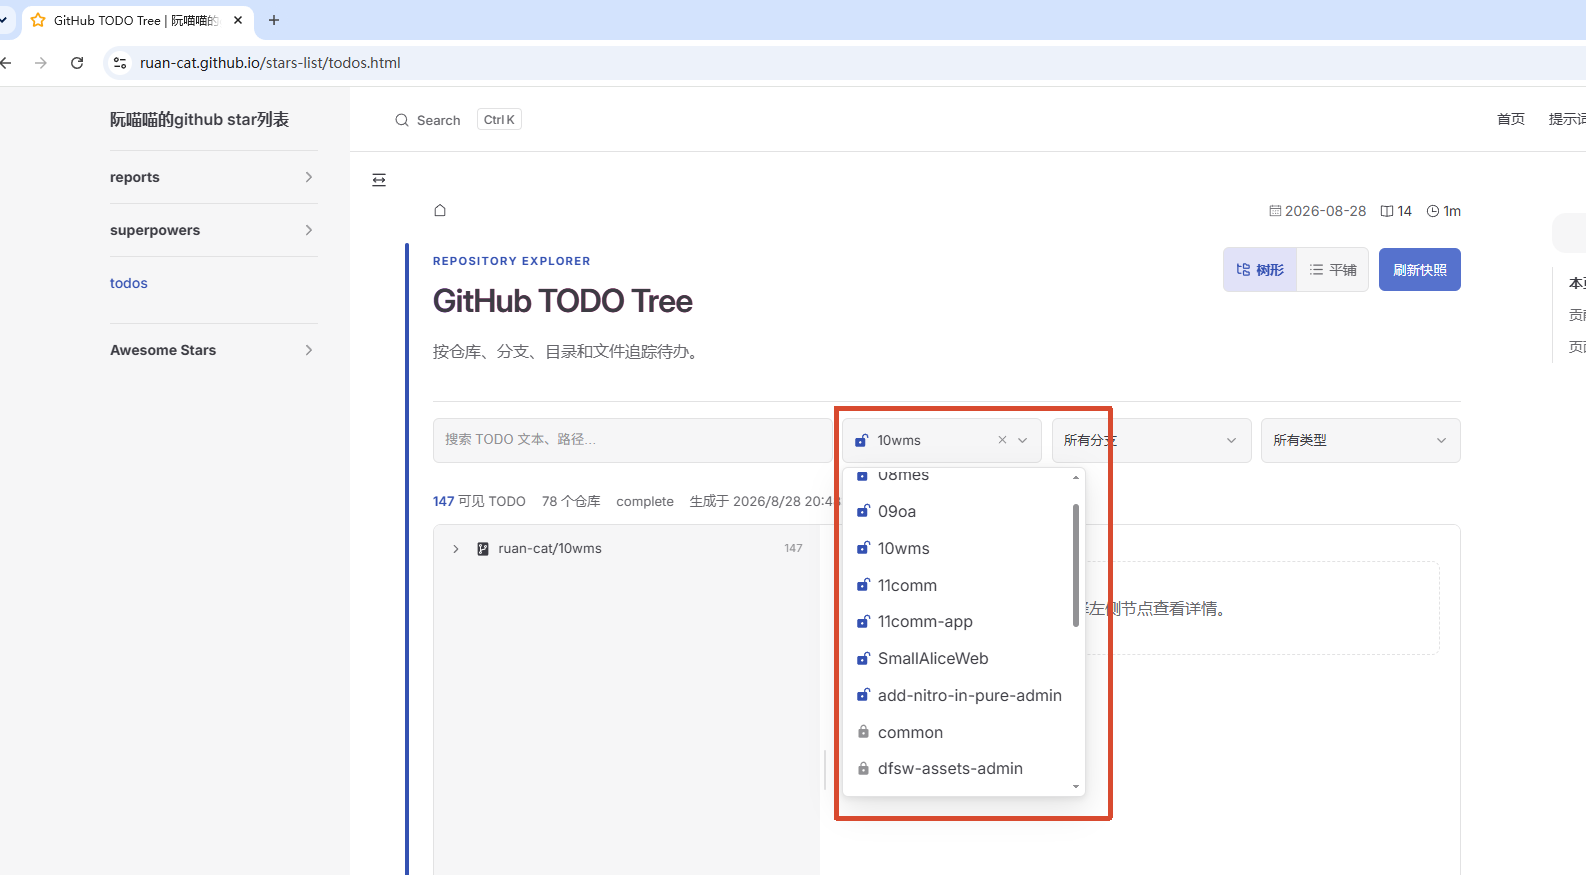
你进入 dev 分支,自己本地启动 dev 开发服务,自己用 agent browser 启动谷歌浏览器,自己完成测试。
010 继续优化 TodoDashboard 的视觉效果
2026-8-30 reka-ui 是不是走弯路了?
但 Reka UI 的 Presence 卸载机制会在关闭时读取元素的 animationName,发现非 none 就等待 animationend——而这个动画只在元素插入时播放一次,关闭时永远等不到,于是弹层永久残留在页面上,还带着事件拦截层,把“点外部关闭”“再点打开”全部挡死。这就是你看到的“关不掉”。
对于这个问题,我非常疑惑,难道用 Reka UI 那么难受么?是不是我们一开始实现这个基础功能的时候,就走弯路走错了?为什么我们是直接使用 reka-ui 呢?而不是使用 shadcn-vue 呢?当初我们设定的目标,就是要这个的。你的 superpower 任务工件根本没告诉你要用 shadcn-vue 来做页面么?为什么这么简单的一个下拉列表,都能被你搞得如此痛苦难堪呢?
你看这个 https://shadcn-vue.com/docs/components/dropdown-menu ,不是很简单清晰么?你是不是一开始的路就走错了?
当初决策就是错的!我们要纠偏!
- 重做你的历史任务工件。我们的本次任务是
继续优化 TodoDashboard 的视觉效果,你重做历史的任务工件,说清楚之前的选用Reka UI的方案很离谱。 - 删除、更改掉旧 memorix 的历史决策,不对。
- 你按照 openspec 系列技能,和 do-long-task 技能的要求,在
openspec\changes\2026-8-30-use-shadcn-vue新建一个长任务工件。我们要新建openspec\changes\2026-8-30-use-shadcn-vue长任务。 2026-8-30-use-shadcn-vue长任务的任务安排:- 迁移 shadcn-vue CLI 。迁移标准的 shadcn-vue 方案。
- 让 tailwindcss 兼容识别主题是 Teek 变量体系。
- 用你的视觉能力,对现在现成的功能。做清晰的记录。确保重构之后,我们不会丢失最基础的功能和视觉效果。你要针对现在的已实现的功能情况,列举清楚功能清单,视觉效果,基础功能,交互情况等一系列
验收细节。确保你重构组件后,我们新的组件实现的效果仍旧和验收细节相对应。 - 用 agent browser 启动本地 dev 进程,在现成的谷歌浏览器实例内打开并阅览界面,收集必要的
验收细节。 - 用 skills 包,去用 context7 MCP,获取到
shadcn-vue组件库对应的最佳实践的指导 skills,安装成项目级别的本地 skills,未来开发将要按照这个要求来完成。 - 用 init-ai-md 技能的指导,及时在 AI 记忆文档内更新你增加的项目级别技能,
- 重构替换现在的组件,从
Reka UI方案换成正规的shadcn-vue和tailwindcss方案。
011 验收审核 openspec\changes\2026-8-30-use-shadcn-vue 任务工件
openspec\changes\2026-8-30-use-shadcn-vue 长任务的截图做的很好,但是我不信任里面的内容是否做的很有深度,很有细节。所以我不放心,需要你来完成审核核验。
另外,上一次任务内,要求的是用 content7 和 find-skills 技能,去找正式的 shadcn-vue 组件库对应的最佳实践的指导 skills,安装成项目级别的本地 skills,未来开发将要按照这个要求来完成。但是上次任务竟然是手写了一个 .agents\skills\shadcn-vue 技能,根本不是去外部找的,也没有触发 skills 包的本地安装,也没有本地的 skills 技能锁文件。这个官方技能需要你去找,找到然后删掉刚才胡乱增加的 .agents\skills\shadcn-vue 技能,然后按照 init-ai-md 技能的指导,更新 AI 记忆文档的要求。
openspec\changes\2026-8-30-use-shadcn-vue 长任务工件,是否说清楚了使用 agent browser 的 Chrome 浏览器完成本地 dev、preview、和生产环境的浏览器实际视觉验收,浏览器交互测试,以及证据截图归档的 spec 规范?
执行推进 openspec\changes\2026-8-30-use-shadcn-vue 长任务
你的测试范围是不是不对啊?你怎么在测试别的页面?按照 openspec\changes\2026-8-30-use-shadcn-vue 最初的任务,不是要测试 todo 页面的迁移改造情况么?你是不是丢失核心任务了?
你怎么反反复复在打开 agent browser 浏览器啊?你是在 goal 任务内丢失了上下文么?还是说你一直在 agent browser 的使用上面绕弯路?重复犯错?
我们暂停一下,你是不是在验证和验收上面遇到问题了?你的自动化验收手段很糟糕么?是不是你的任务工件写的有误导啊?
我不相信你 6 个小时都还没搞好这个任务,你是不是过渡实验,过度验收了?还是说你的验收标准过于严苛了?你在截图上面遇到很多故障么?
真正浪费时间的部分是你在使用 agent browser 时没有及时止损:
- 把单个场景拆成多个浏览器 session;
- 短暂跑偏到普通文档页;
- 在控制面不稳定时反复尝试,而不是先固定健康探针和失败边界;
- 产生了不少“局部有效、整体不能验收”的截图。
你现在临时给我去 .agents\skills\use-agent-browser 目录内写一个技能,指导你到底要如何高效的使用 agent browser 。避免你出现在 goal 长任务内出现滥用,误用,低效使用 agent browser 的情况。
你现在继续在 .agents\skills\use-agent-browser\SKILL.md 的合理指导下,继续完成验证吧。别过度处理了。如果任务清单内的验收条件过于苛刻,你停下来和我讨论一下都行。别硬着头皮死脑筋。
你的清单门槛是不是太高了?超出 agent browser 的能力了?还是超出什么能力了?你有能力实现,结果你在测试和满足门槛上面耗费了接近 8 小时和大量的 token。你真的很离谱啊。你是不是设计了超出我们现有工具复核能力的标准了?是不是你一开始的指标和测试方式就烂了?
你给我写一个报告,给我一个交代。
- 我现在确认要重新设计更加合理的验收门槛,以及合理的 agent browser 的 session 浏览器会话设计。更新任务工件。
- 更新
.agents\skills\use-agent-browser\SKILL.md技能,做到很好的 session 指导。
你为什么过度扣 4.2 的像素 diff 是 4.60%,明确未通过。的事情呢?我们页面是响应式的,你都不考虑响应式就做验收么?你怎么钻牛角尖啊?扣像素?
我们 openspec\changes\2026-8-30-use-shadcn-vue\evidence 里面确实有很多截图,你是不是过于迷信截图的离谱严苛标准了?所以你才没办法认为功能完成验收了?而在视觉上面陷入完美主义,过度拘泥无意义的细节了?只要不太偏离离谱就行了,你是不是过于死磕完整复原了?
我注意到你在 openspec\changes\2026-8-30-use-shadcn-vue 内设计了很多无障碍相关的功能,这些功能你是怎么实现的?你使用那些现成的方案实现的?你在用 agent browser 做测试时,agent browser 有合适的办法实现对前端项目无障碍功能的测试么?是不是测试的时候遇到困难了?你需要额外写脚本来实现无障碍功能的测试么?你要更新局部技能 .agents\skills\use-agent-browser 么?
执行 openspec\changes\2026-8-30-use-shadcn-vue 长任务
继续执行 openspec\changes\2026-8-30-use-shadcn-vue 长任务
012
贡献者
 ruan-cat
 MiniMax